Auditoría de seguridad asistida por IA en tu pipeline CI/CD: qué automatizar y qué revisar a mano
Semgrep, Snyk y la revisión automática de PRs cubren buena parte del escaneo continuo, pero no todo. Aquí va un checklist para decidir qué automatizar en CI/CD y qué seguir revisando a mano.

Auditoría de código con IA en CI/CD: herramientas, métricas y límites de la revisión automática
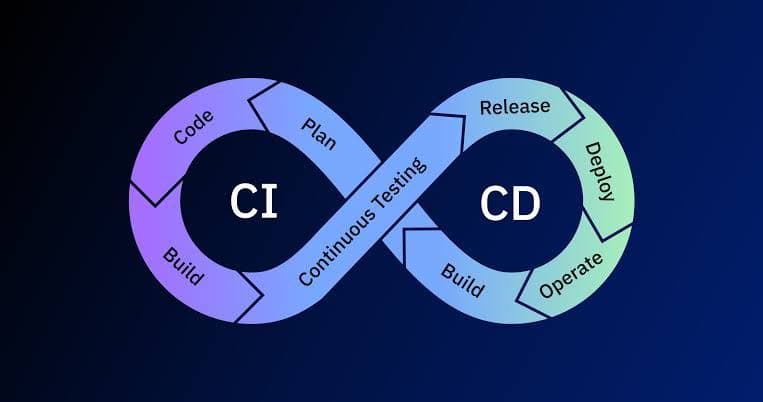
Etapas del pipeline donde la IA aporta valor real
Cuando alguien habla de «auditoría de código con IA», normalmente está mezclando tres actividades distintas: análisis estático de código (SAST), análisis de dependencias y contenedores, y revisión de código mediante modelos de lenguaje (LLM).
Herramientas como Semgrep y CodeQL analizan patrones de código y posibles vulnerabilidades. Snyk, Trivy y Dependabot ayudan a identificar problemas en dependencias, imágenes de contenedores y componentes desactualizados. Los modelos de lenguaje, por su parte, pueden revisar cambios, explicar fragmentos complejos y señalar posibles errores de lógica.
No todas estas capacidades son inteligencia artificial generativa. El análisis estático tradicional se basa principalmente en reglas y técnicas de análisis de código, aunque algunas plataformas incorporan aprendizaje automático para priorizar resultados o facilitar su clasificación.
Una regla práctica para decidir qué automatizar es que cuanto antes se detecta un problema, menor suele ser el costo de corregirlo. Sin embargo, ejecutar todos los análisis en todas las etapas puede aumentar los tiempos del pipeline y generar alertas innecesarias.
El objetivo no es encontrar absolutamente todo en cada ejecución, sino detectar los problemas relevantes en el momento adecuado y con suficiente contexto para corregirlos.
Pre-commit: barato, local y con fricción
Los hooks locales permiten ejecutar comprobaciones antes de crear un commit. Por ejemplo, se puede utilizar Semgrep para revisar archivos modificados o ejecutar un detector de secretos para evitar que una credencial termine en el repositorio.
Esta estrategia reduce el costo de detección porque el desarrollador recibe información inmediata y no necesita esperar a que termine un pipeline remoto.
El problema es que los hooks locales dependen de la configuración de cada equipo. Pueden estar desactivados, no instalarse correctamente o saltarse mediante opciones como --no-verify.
Por eso conviene utilizarlos como una primera línea de defensa, sin convertirlos en el único mecanismo de seguridad.
Pull request: el punto de mayor retorno
El pull request es uno de los mejores lugares para concentrar las comprobaciones de seguridad. En esta etapa se pueden ejecutar pruebas, analizar código, revisar dependencias y solicitar una evaluación adicional mediante un modelo de lenguaje.
El análisis diferencial permite concentrarse en los cambios nuevos, evitando que un repositorio con años de deuda técnica produzca cientos de alertas en cada ejecución.
No obstante, analizar únicamente las líneas modificadas no siempre es suficiente. Una modificación aparentemente pequeña puede introducir una vulnerabilidad en una función antigua o alterar una condición de autorización definida en otro archivo.
Una estrategia razonable consiste en combinar:
- Análisis de los cambios del pull request para detectar problemas nuevos.
- Análisis del contexto necesario para comprender funciones, dependencias y permisos relacionados.
- Escaneos completos periódicos para identificar vulnerabilidades existentes fuera del diff.
- Bloqueos automáticos para los hallazgos nuevos que cumplan los criterios de riesgo definidos por el equipo.
Post-merge y monitoreo
Una vez integrados los cambios en la rama principal, se pueden ejecutar análisis más amplios, generar un inventario de componentes de software (SBOM) y revisar las vulnerabilidades que afectan a las dependencias instaladas.
Este proceso permite detectar problemas que aparecen después de la publicación del código, por ejemplo, cuando se descubre una vulnerabilidad en una biblioteca que antes no tenía alertas.
No todos los hallazgos necesitan bloquear el pipeline posterior a la integración. Algunos pueden convertirse en tareas priorizadas, mientras que las vulnerabilidades críticas que afecten a componentes desplegados deben activar el procedimiento de respuesta definido por la organización.
Producción: poca IA útil sin una buena base operativa
En producción, las prioridades siguen siendo la observabilidad, los registros estructurados, las métricas, las alertas, la protección de aplicaciones y la respuesta a incidentes.
Un modelo puede ayudar a resumir grandes volúmenes de logs o identificar patrones sospechosos, pero necesita información de calidad y controles para evitar conclusiones incorrectas.
Antes de implementar una solución de análisis de logs con IA, conviene comprobar si las mismas necesidades pueden resolverse mediante dashboards, consultas, reglas de correlación y alertas convencionales.
La IA aporta más valor cuando reduce un trabajo concreto de investigación que cuando simplemente añade otra capa de alertas.
Herramientas y configuración inicial
Semgrep
Semgrep analiza el código mediante reglas que identifican patrones sintácticos y semánticos. Es especialmente útil para detectar construcciones peligrosas, errores recurrentes y prácticas que el equipo quiere evitar.
Existen diferencias importantes entre sus comandos:
semgrep scanpermite ejecutar análisis desde la CLI utilizando reglas públicas o locales, según la configuración.semgrep ciestá orientado a flujos de integración continua y puede aprovechar las capacidades de la plataforma asociada cuando corresponda.
La elección depende de si se necesita una ejecución independiente o una integración con servicios de gestión y seguimiento de hallazgos.
Una regla sencilla para identificar usos de eval() en PHP puede servir como punto de partida:
rules:
  - id: php-eval-uso
    languages:
      - php
    severity: ERROR
    message: "Uso de eval(); revisa si es realmente necesario."
    pattern: eval(...)
Esta regla es ilustrativa. Antes de utilizarla como control de seguridad obligatorio, hay que validar su compatibilidad con la versión de Semgrep instalada, probarla con ejemplos positivos y negativos y determinar si existen casos legítimos en el proyecto.
Una regla que encuentra una construcción peligrosa no demuestra por sí sola que exista una vulnerabilidad explotable. El riesgo depende del origen de los datos, de las validaciones y del contexto de ejecución.
Snyk
Snyk permite analizar dependencias mediante SCA y, según el producto y la configuración disponibles, realizar análisis estático del código.
Entre sus comandos habituales se encuentran:
snyk test: analiza dependencias y sus vulnerabilidades conocidas.snyk code test: ejecuta análisis de código mediante las capacidades de Snyk Code.
La disponibilidad de estas funcionalidades depende del producto, la cuenta y la licencia. Antes de incorporarlas a un pipeline, hay que validar los permisos y requisitos de autenticación.
El uso de --severity-threshold=high permite limitar los resultados que se presentan a partir de ese umbral, pero no significa que los problemas de severidad inferior dejen de existir.
Una política más completa debe contemplar la severidad, la posibilidad de explotación, la exposición del componente y la existencia de una solución disponible.
Escaneo de secretos
Detectar secretos requiere una herramienta específica. Dependabot está orientado principalmente a las actualizaciones y vulnerabilidades de dependencias; no sustituye un escáner de credenciales.
Herramientas como Gitleaks y TruffleHog pueden ayudar a identificar tokens, contraseñas, claves privadas y otras credenciales expuestas.
Conviene ejecutar análisis sobre los cambios nuevos y, durante la incorporación inicial de la herramienta, evaluar también el historial del repositorio.
Hay una distinción fundamental: eliminar una contraseña de un archivo no elimina necesariamente el riesgo. Si la credencial llegó a un repositorio remoto, puede permanecer en commits anteriores, clones, forks, registros o copias de seguridad.
Cuando se confirma la exposición de una credencial real, la prioridad es revocarla o rotarla y revisar su alcance. La limpieza del historial puede ser necesaria, pero no reemplaza esa acción.
Revisión de pull requests con LLM
Un modelo de lenguaje puede ayudar a identificar errores de lógica, sugerir pruebas, explicar cambios complejos y señalar patrones que merecen una revisión adicional.
Sin embargo, su resultado debe tratarse como una recomendación, no como una certificación de seguridad.
Antes de integrar esta capacidad, conviene definir:
- Qué archivos y fragmentos de código se envían al proveedor.
- Qué políticas de retención, entrenamiento y acceso se aplican.
- Si el código contiene información confidencial, datos personales o secretos.
- Qué modelo y configuración están autorizados por la organización.
- Cómo se registran y verifican las recomendaciones.
- Qué decisiones requieren aprobación humana.
Un modelo autoalojado puede reducir la exposición a terceros, pero no elimina los riesgos de acceso indebido, registros inseguros o configuraciones incorrectas.
El objetivo debe ser incorporar una revisión adicional sin permitir que el modelo apruebe automáticamente cambios sensibles solo porque no encontró problemas.
Ejemplo de integración en GitHub Actions
El siguiente ejemplo muestra una base para ejecutar Semgrep en pull requests y en la rama principal, junto con análisis de dependencias mediante Snyk.
Antes de adoptarlo, hay que validar las versiones de las acciones, la disponibilidad de las funciones según las licencias contratadas y la configuración de seguridad del repositorio.
name: security

on:
  pull_request:
  push:
    branches:
      - main

permissions:
  contents: read
  security-events: write

jobs:
  semgrep:
    runs-on: ubuntu-latest

    container:
      image: semgrep/semgrep

    steps:
      - uses: actions/checkout@v4

      - name: Analizar código con Semgrep
        run: |
          semgrep scan \
            --config=auto \
            --sarif \
            --output=semgrep.sarif

      - name: Publicar resultados SARIF
        if: always()
        uses: github/codeql-action/upload-sarif@v3
        with:
          sarif_file: semgrep.sarif

  snyk:
    runs-on: ubuntu-latest

    steps:
      - uses: actions/checkout@v4

      - name: Instalar Snyk CLI
        run: npm install -g snyk

      - name: Analizar dependencias
        run: snyk test --all-projects --severity-threshold=high
        env:
          SNYK_TOKEN: ${{ secrets.SNYK_TOKEN }}

      - name: Analizar código propio
        run: snyk code test --severity-threshold=high
        env:
          SNYK_TOKEN: ${{ secrets.SNYK_TOKEN }}
La publicación del archivo SARIF permite integrar los resultados con las herramientas de seguridad compatibles de GitHub. La visualización y el procesamiento de alertas dependen de las funcionalidades habilitadas en el repositorio.
Este ejemplo no implementa por sí solo un análisis diferencial ni una política de bloqueo basada en hallazgos nuevos. Tampoco garantiza que todos los trabajos terminen ejecutándose si uno de ellos falla.
Si el objetivo es evitar que una vulnerabilidad nueva llegue a producción, hay que configurar las reglas de protección de ramas y las comprobaciones obligatorias de estado de acuerdo con la política del equipo.
Las versiones mostradas son referencias de ejemplo, no una recomendación de utilizar versiones sin revisar. Para producción, conviene fijar las versiones de las acciones y las herramientas, mantenerlas actualizadas y evaluar el uso de referencias inmutables para las acciones de GitHub.
Ejemplo de integración en GitLab CI
Una configuración inicial de GitLab CI puede publicar el resultado de Semgrep como artefacto para facilitar su consulta posterior:
stages:
  - test

semgrep:
  stage: test
  image: semgrep/semgrep

  rules:
    - if: '$CI_PIPELINE_SOURCE == "merge_request_event"'
    - if: '$CI_COMMIT_BRANCH == $CI_DEFAULT_BRANCH'

  script:
    - semgrep scan --config=auto --sarif --output=semgrep.sarif

  artifacts:
    when: always
    expire_in: 1 week
    paths:
      - semgrep.sarif
Guardar el archivo SARIF como artefacto no significa que GitLab vaya a convertirlo automáticamente en un informe de seguridad integrado. Para ello se debe comprobar el formato de informe compatible con la versión y las funcionalidades de GitLab utilizadas, o configurar una integración adicional.
También es necesario decidir si un hallazgo debe fallar el job. El comportamiento por defecto de una herramienta no siempre coincide con la política de seguridad deseada.
Cuándo no vale la pena
No todos los proyectos necesitan una plataforma completa de auditoría asistida por IA.
- Repositorio pequeño con una sola persona responsable: un análisis básico de dependencias, un detector de secretos y algunas reglas de SAST pueden ser suficientes.
- Equipo sin capacidad de triage: activar muchas herramientas simultáneamente puede producir una lista de alertas que nadie mantiene. Es mejor comenzar con una selección pequeña y ampliar progresivamente.
- Prototipos que no manejan datos sensibles ni se despliegan: la inversión inicial puede superar el beneficio inmediato, aunque sigue siendo recomendable evitar credenciales reales y dependencias sospechosas.
- Código regulado o con información confidencial: la prioridad debe ser establecer controles de acceso, trazabilidad, protección de datos y criterios de cumplimiento antes de incorporar servicios externos de IA.
La decisión no debería basarse únicamente en el tamaño del repositorio. Una aplicación pequeña que administra pagos, identidades o información personal puede necesitar controles más estrictos que una aplicación mucho más grande con menor impacto potencial.
Falsos positivos y métricas de ruido
Un pipeline que genera cien hallazgos semanales y obliga al equipo a investigar problemas irrelevantes puede terminar siendo contraproducente. Cuando las alertas pierden credibilidad, también aumenta la probabilidad de que se ignore una vulnerabilidad real.
La solución no consiste en eliminar todas las alertas difíciles de interpretar, sino en medir su utilidad y mejorar progresivamente las reglas.
Suprimir con justificación, no con silencio
Semgrep permite documentar determinadas excepciones mediante comentarios de supresión asociados a una regla. Por ejemplo:
// nosemgrep: php-eval-uso
// Excepción revisada en SEC-482: entrada validada mediante lista permitida.
La sintaxis y el alcance de las supresiones deben validarse para la versión de Semgrep y la regla utilizada. También es importante comprobar que la excepción no oculte otros hallazgos relevantes.
Snyk permite gestionar excepciones mediante su plataforma y, en determinados flujos, mediante un archivo .snyk versionado.
Ejemplo ilustrativo:
version: v1.25.0
ignore:
  SNYK-PHP-EXAMPLE-12345:
    - '*':
        reason: "La ruta vulnerable no se alcanza desde el código propio."
        expires: 2026-12-31T00:00:00.000Z
El identificador de vulnerabilidad del ejemplo es ficticio y debe reemplazarse por uno real. La estructura exacta y las opciones admitidas deben verificarse con la versión de Snyk utilizada.
Una excepción sin fecha de expiración puede convertirse en una vulnerabilidad olvidada. Por eso conviene exigir una justificación, un responsable y una fecha de revisión, además de un ticket cuando corresponda.
Qué medir
No existe un porcentaje universal de falsos positivos que funcione para todos los equipos. La métrica útil depende de la herramienta, el tipo de aplicación y la forma en que se clasifican los hallazgos.
Estas son algunas medidas que permiten evaluar el comportamiento del pipeline:
- Hallazgos nuevos por pull request: permite observar cuánto trabajo de revisión genera cada cambio.
- Porcentaje de falsos positivos confirmados: muestra qué proporción de los hallazgos revisados no corresponde a un problema real.
- Tiempo medio de resolución: mide cuánto tarda el equipo en corregir los problemas confirmados.
- Porcentaje de hallazgos reabiertos: ayuda a detectar correcciones incompletas o clasificaciones incorrectas.
- Número de excepciones vencidas: permite identificar riesgos que siguen ocultos después de terminar su periodo de aceptación.
- Cobertura de revisión: indica qué proporción de los hallazgos relevantes recibe una decisión documentada.
Para calcular el porcentaje de falsos positivos se puede utilizar:
Falsos positivos / Hallazgos revisados × 100
Es importante utilizar como denominador los hallazgos revisados, no todos los generados. De lo contrario, la métrica puede dar una impresión incorrecta de la calidad del análisis.
Por ejemplo, si se revisan 40 hallazgos y 10 se clasifican como falsos positivos, el porcentaje observado es del 25 %. Ese valor no demuestra que la herramienta tenga una precisión general del 75 %, porque los hallazgos no revisados y las vulnerabilidades que la herramienta no detectó también importan.
Cómo convertir las métricas en decisiones
Imaginemos un equipo que recibe 50 alertas nuevas durante una semana. Después de revisarlas, encuentra 12 falsos positivos, 8 problemas reales que requieren corrección y 30 hallazgos que siguen pendientes de clasificación.
En ese escenario, subir el umbral de severidad para silenciar todas las alertas no resuelve el problema: los 30 hallazgos pendientes todavía no han sido evaluados.
Una estrategia más útil consiste en identificar las reglas que producen mayor volumen de falsos positivos, crear casos de prueba para ellas, revisar las exclusiones y medir el resultado durante las siguientes semanas.
El equipo puede establecer objetivos operativos, por ejemplo, que las alertas críticas nuevas se revisen antes de integrar un cambio y que todas las excepciones tengan responsable y fecha de revisión. Estos son objetivos internos que deben adaptarse al riesgo y a la capacidad real del equipo, no umbrales universales.
Si el porcentaje de falsos positivos aumenta, conviene revisar las reglas, mejorar el contexto del análisis y corregir los conjuntos de reglas heredados antes de desactivar controles completos.
Checklist de revisión humana: qué no delegar a la IA
Los escáneres y los modelos de lenguaje ayudan a detectar problemas, pero hay decisiones de seguridad que requieren conocer el negocio, los permisos y el entorno real de ejecución.
Autorización y lógica de negocio
Un SAST puede detectar consultas SQL inseguras o patrones de acceso sospechosos. Sin embargo, puede no identificar que un endpoint permite a un usuario consultar los pedidos de otra empresa porque la consulta no filtra por el identificador del tenant.
Por ejemplo, imaginemos un endpoint de Laravel:
public function show(int $id)
{
    return Order::findOrFail($id);
}
El código puede funcionar correctamente desde el punto de vista sintáctico y no presentar una inyección SQL. Sin embargo, si no existe un control de autorización adicional, un usuario podría intentar consultar pedidos que pertenecen a otro cliente.
Una posible solución consiste en utilizar la relación del usuario autenticado o aplicar una política de autorización:
public function show(int $id)
{
    $order = Order::query()
        ->where('tenant_id', auth()->user()->tenant_id)
        ->findOrFail($id);

    return $order;
}
Este ejemplo es ilustrativo: la implementación correcta depende del modelo de usuarios, las relaciones y la estrategia multiempresa del proyecto.
La revisión humana debe comprobar, como mínimo:
- Que el usuario solo pueda consultar recursos autorizados.
- Que las operaciones de actualización y eliminación apliquen los mismos controles.
- Que las políticas de autorización se mantengan también en tareas asíncronas y endpoints secundarios.
- Que los identificadores de empresa, propietario o usuario no se acepten como prueba suficiente de autorización.
- Que existan pruebas negativas que intenten acceder a recursos de otro tenant.
Este es uno de los motivos por los que una revisión basada únicamente en patrones de código no sustituye las pruebas de autorización.
Secretos: alcance y rotación
Una herramienta puede identificar una clave expuesta, pero no siempre conoce su estado actual, los permisos asociados ni los sistemas que dependen de ella.
La respuesta debe incluir la comprobación de si la credencial sigue activa, la revocación o rotación cuando corresponda, la revisión de sus permisos y la búsqueda de posibles usos indebidos.
También hay que revisar el historial del repositorio y otros lugares donde la credencial pueda haberse copiado.
Cadena de suministro
Que una dependencia tenga un CVE es distinto de determinar si el paquete es legítimo.
Los ataques de typosquatting, las cuentas de mantenedores comprometidas y los paquetes maliciosos pueden no quedar cubiertos por un análisis convencional de vulnerabilidades conocidas.
Antes de incorporar una dependencia nueva, conviene revisar su procedencia, el nombre exacto del paquete, su actividad de mantenimiento, el historial de versiones y los permisos o scripts que ejecuta durante la instalación.
En proyectos críticos, también se pueden incorporar controles de integridad, revisión de lockfiles y políticas de procedencia de artefactos.
Criptografía y datos personales
Las implementaciones propias de cifrado, generación de tokens y manejo de información sensible requieren una evaluación contextual.
No basta con comprobar que el código utiliza un algoritmo reconocido. También hay que revisar la generación y el almacenamiento de claves, la gestión de sesiones, la expiración de tokens, los controles de acceso y la eliminación de información cuando deja de ser necesaria.
Cuando existen obligaciones regulatorias, las decisiones deben contrastarse con los requisitos legales y contractuales aplicables. Un modelo puede ayudar a localizar riesgos, pero no sustituye una evaluación jurídica o de cumplimiento.
Las supresiones
Aprobar una excepción de Semgrep o ignorar una vulnerabilidad en Snyk es una decisión de riesgo.
Cada excepción debería indicar el motivo, el alcance, la persona responsable y la fecha de revisión. En función de la gravedad, también puede requerir aprobación de seguridad o del responsable técnico.
Una supresión no debería aceptarse únicamente porque el modelo de lenguaje afirma que el hallazgo es un falso positivo. Debe existir evidencia verificable que justifique la decisión.
El código generado por IA
El código producido por asistentes de programación debe pasar por los mismos controles que el código escrito manualmente.
Entre los problemas que conviene revisar se encuentran:
- Dependencias inexistentes o paquetes con nombres parecidos a los legítimos.
- Validaciones insuficientes y controles de autorización incompletos.
- Manejo de errores que oculta fallos relevantes.
- Credenciales de ejemplo que terminan incorporadas al repositorio.
- Pruebas que solo cubren el camino exitoso.
- Uso de APIs obsoletas o patrones inseguros.
Una política útil consiste en exigir que las dependencias nuevas y los cambios relacionados con autenticación, autorización, criptografía y datos sensibles reciban una revisión explícita.
La IA puede acelerar la implementación, pero no elimina la responsabilidad del equipo sobre el resultado.
Plan de implementación progresiva
Para evitar que la auditoría se convierta en un proyecto de configuración interminable, es preferible incorporar los controles en etapas.
Etapa 1. Visibilidad
- Ejecutar un análisis inicial de código y dependencias.
- Detectar secretos expuestos.
- Registrar los hallazgos existentes.
- Clasificar los riesgos prioritarios.
- Establecer una línea base para distinguir los problemas históricos de los nuevos.
Etapa 2. Control de cambios
- Ejecutar análisis automáticos en los pull requests.
- Configurar las comprobaciones obligatorias de integración.
- Bloquear los hallazgos nuevos que cumplan los criterios de riesgo acordados.
- Exigir justificación y revisión para las excepciones.
Etapa 3. Mejora del triage
- Revisar las reglas con mayor número de falsos positivos.
- Incorporar pruebas para los patrones críticos.
- Medir los tiempos de revisión y resolución.
- Añadir revisión con LLM cuando exista un caso de uso concreto y una política de protección del código.
Etapa 4. Mantenimiento continuo
- Ejecutar análisis completos periódicos.
- Actualizar herramientas y conjuntos de reglas.
- Revisar las excepciones vencidas.
- Monitorizar vulnerabilidades nuevas en dependencias.
- Ajustar los controles cuando cambien la arquitectura o el perfil de riesgo.
Esta secuencia permite comenzar con controles sencillos y aumentar la cobertura a medida que el equipo desarrolla la capacidad de revisar y corregir los hallazgos.
Resumen
La IA puede aportar valor en la auditoría de código cuando ayuda a revisar cambios, explicar problemas complejos, sugerir pruebas y reducir el trabajo manual de clasificación.
Sin embargo, no sustituye el análisis estático, la revisión de dependencias, la detección de secretos ni la validación de las reglas de negocio. Tampoco garantiza que una aplicación sea segura porque una ejecución no haya producido alertas.
Una estrategia sostenible combina herramientas especializadas, revisión humana y criterios de bloqueo proporcionales al riesgo.
El diseño que mejor envejece es el que distingue la deuda histórica de los problemas nuevos, exige justificación para las excepciones, mide la utilidad de las alertas y mejora progresivamente las reglas.
La pregunta importante no es cuántas vulnerabilidades encuentra una herramienta, sino cuántos problemas relevantes consigue detectar el equipo, corregirlos a tiempo y evitar que vuelvan a aparecer.
Si estás incorporando estos controles en tu equipo y quieres contrastar decisiones —qué bloquear, qué excepciones aceptar y cómo medir el ruido—, puedes revisar el enfoque con un caso concreto de tu arquitectura y tu pipeline.
Desarrollador de software. ¿Te sirvió o tienes un caso parecido? Escríbeme.